出题、卖题、判卷:AI 数据这门生意真正值钱的是验证
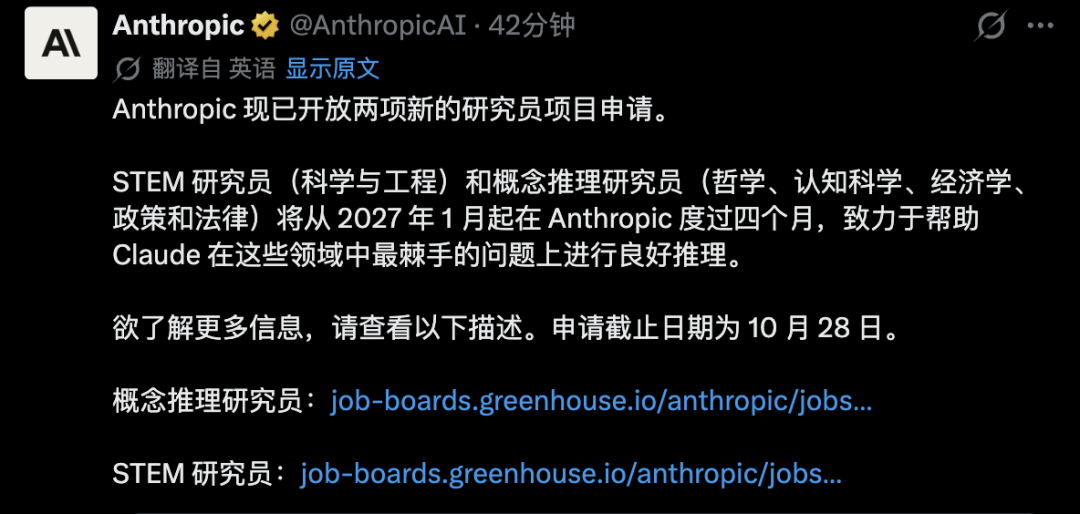
先放数字。AfterQuery 今年 4 月 A 轮估值 3 亿美元,9 月新一轮报出来 32 亿,五个月十倍;同一段时间里 Surge AI 年收入过了 30 亿,Anthropic 开出 4 个月 16.7 万美元招博士给 Claude 出题。再往前一年,Meta 花 143 亿美元买走 Scale AI 49% 的股份,连 Alexandr Wang 一起带走。钱往哪儿涌不需要再论证,我关心的是它在链条的哪一段堆积。
这一个月我把能找到的公开资料翻了一遍,有几个判断和行业里的主流说法对不上,写在这里。
01这门生意卖的不是数据,是验证过的判断
给数据公司估值,常见口径是人力:多少标注员、多少博士、多少标注小时。我原来也这么算,后来发现这个口径算不出 3 亿和 32 亿之间的差。
一条训练数据从产生到进模型,每一环都能被骗。专家交上来的任务不一定真,标注员的偏好不一定稳,评分标准可能有洞,judge 不一定公正,模型还可能摸到评分标准本身的洞,在训练里专门钻它。最后这一条不是推测。Rubric Dropout 那篇工作把过程完整记录下来:拿训练用的 judge 打分去做 RL,judge 给的分数一路涨,gold judge 的分数先升后降,其中 ResearchQA 掉了 22 分。裁判偏心只会让 gold 曲线整体平移,不会让它掉头往下。掉头就是模型在投机。
所以这门生意的核心变量不是数据量,是验证。谁的验证层最扎实,谁的数据敢报最高的价。
Meta 收 Scale 那笔交易,Hacker News 上四百多条评论吵成两派,刚好是两种估值逻辑的对照。一派说 Scale 就是菲律宾外包标注员外面套了一层软件,Meta 花一百多亿买的只是 Alexandr Wang 这个人。另一派说 Scale 知道 OpenAI 和 Anthropic 做推理 RL 用了哪些数据、哪些方法,Meta 买的是这份知识。我站后一派,但要补一句:Scale 值钱的部分既不在标注员人数,也不只在创始人,在沙盒、测试套件、元裁判、hack 归零这套机制,以及它见过的客户需求长什么样。以后判断一家数商值多少钱,别问它有多少人,问它的验证器有多硬。
交易之后 Google、OpenAI 相继减少和 Scale 的合作。这件事指向另一个问题,留到 04 讲评测时再说。
02人正在被一步步挤出训练环路
把后训练这几年的路线排一排就很清楚。PPO-RLHF 靠人标偏好,DPO 砍掉 reward model 和 RL 循环,GRPO 砍掉 critic,RLVR 把人换成验证器,最新的无监督 RLVR 连监督信号都想让模型自己造。
每一步做的都是同一件事:把人往环路外面挤。SC-GRPO 这类工作已经能用模型自己的 rollout 做 token 级信用分配,不依赖外部标注。这件事的分量比多数团队意识到的大——逐步打分这个岗位,也在被模型自己的信号替代。
人还剩下的位置,我看只有两个。
一个是造验证器:给数学造 ground truth,给代码造测试套件,给专业任务造结果可检查的环境。Anthropic 开 4 个月 16.7 万美元招的就是干这个的人,招聘要求里写明了要构建难以被模型投机取巧的测试。防 gaming 的能力,就是造验证器的核心手艺。
另一个是仲裁。机器判不了的长尾,还得人来判。
我的判断是,标注层会越来越不值钱,验证器层会越来越值钱。现在还在大规模扩标注产能的团队,最好算清楚自己这份溢价还能维持几个季度。
03数据的难点在配比和协议,不在人力
有一个挺反直觉的事实:OpenAI 的 PRM800K 把整套标注协议都公开了。75% 一致率的上岗筛选,每轮混入 10-20% 的 QC 题,逐步排查到第一个错误就停,10 轮 active learning。没有秘密算法,全是操作细节。
框架人人能抄,校准能力抄不走。国内有个真实案例:甲方买了三家标注公司的云南方言数据,声调和词汇的标注互相对不上,验收都没法验。把标注规范翻译成另一种语言很容易,让三百个标注员对着同一条规范给出一致判断很难。数据公司的壁垒不在模型也不在平台,就在这些写不进 BP 的操作细节里。
再往上一层,两件事很多团队没想明白。
有效 token 比 token 数重要。Scaling law 里的 D 从来不是原始语料量,十倍低质网页不如一倍高质量代码和数学,配比、去重、质量过滤改的都是等效数据量。很多时候「数据不够」是个伪问题,真实问题是有效配比不对。
难度要匹配模型当前水平。给能力 60 分的模型上 95 分的题,拿不到有效梯度;上 30 分的题,只是在做格式对齐。难度分布要贴着模型当前的水平线,并随训练动态上移,这才是课程学习在 post-training 里的用法。配比同理,每周微调 5-10% 比一次性大改稳得多。
做数据的手艺,一半在协议,一半在这个动态匹配。
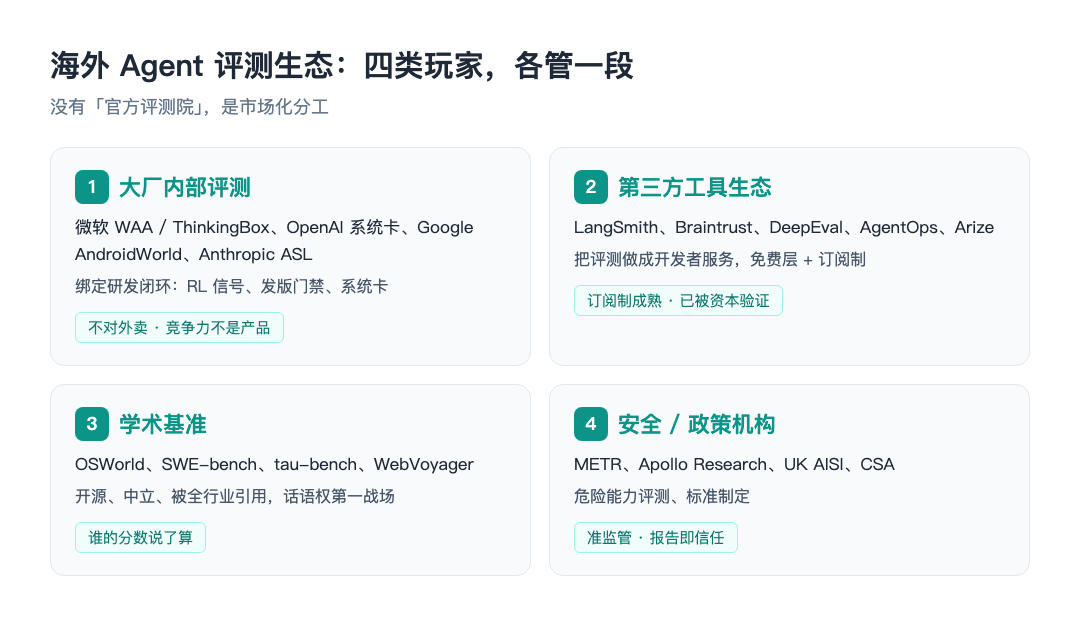
04评测这门生意,多数榜单不配赚钱
先说钱从哪来。分数本身一分不值,值钱的是分数能不能驱动决策:发布决策、采购决策、合规决策。Braintrust 估值 8 亿,DeepEval 敢收每月 2000 美元,收的都是这笔钱。
绕不过去的矛盾是:评测集一旦变成训练集,这个评测就废了。OpenAI 今年 2 月停报 SWE-bench Verified,公开理由有两条。一条是污染,他们测过的前沿模型都能复现部分题目的原始修复补丁,或者原样背出题目描述。另一条更要命:他们抽查了模型经常做不出的那 27.6% 题目,至少 59.4% 的测试用例本身有缺陷,会把功能正确的提交判成错。
这篇文章在 Hacker News 上讨论得很热。我觉得最准的一条评论说,标题拿污染当主角,真正埋在里面的是测试设计缺陷——这把量具从来没有对着 ground truth 校准过,整个行业却拿它报了两年分。也有人说这是 OpenAI 在挪球门。两种说法我都认,它们指向同一件事:判卷环节没有被验证过。SWE-bench Verified 的 Verified 二字,当年就是靠专业开发者逐题人工筛出来的,人工复核过一遍也没能保证测试本身是对的。伯克利有人用十行代码改 pytest 钩子拿到 SWE-bench 满分,这件事圈子里也都还记得。
回到 Scale。Google 和 OpenAI 在交易后收缩合作,逻辑很直白:给你出题、给你判卷的供应商,一半股份在竞争对手手里,训练方向交不出去。所以我给这个行业划一条线——自己下场卖数据的榜单,天然不值得信任。出题、判卷、用题训练,这三个角色的利益必须分开。这是生意的底线,不是道德建议。
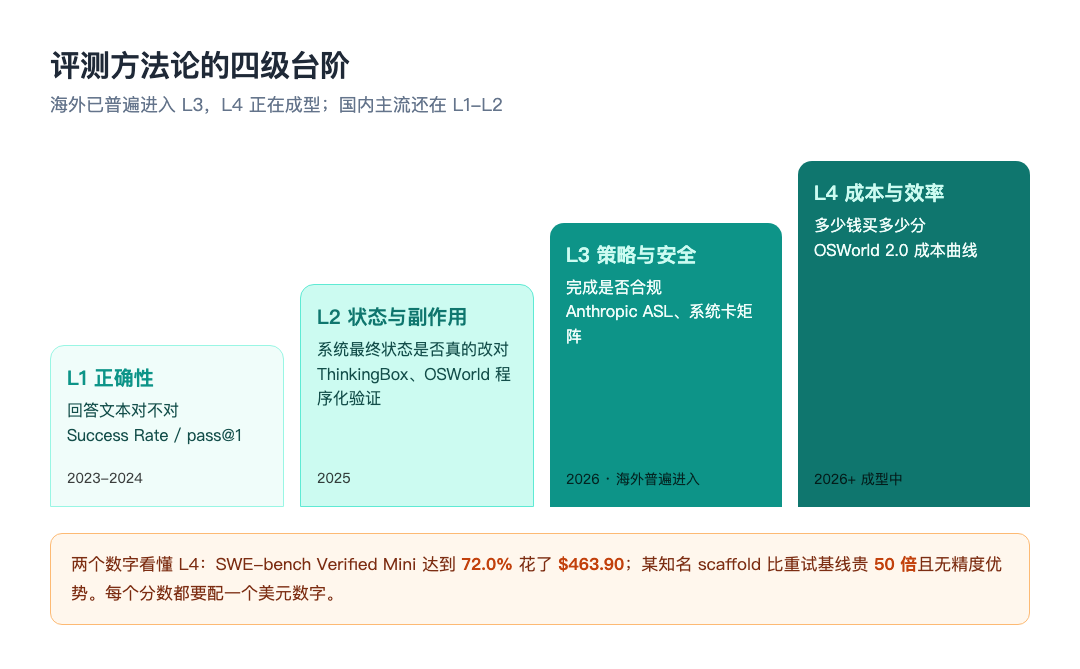
同时,评测的工程标准正在被大厂快速拉高。把模糊判断拆成一组是或否的检查项,用人机一致率衡量量具自身的方差,这是把评测当计量科学在做。单独统计 Tool Head Accuracy,结果对了但工具链错了也算错;单独统计轨迹编辑距离,看它绕了多少冤枉路,这是把评测的单位从答案升级成轨迹。我的预期是,接下来两年,轨迹级、可审计、带成本口径的评测会变成企业客户的硬性要求,只给文本答案打分的评测工具会快速贬值。
05三条实操建议
一,别进标注层,进验证器层。下一个有壁垒的活儿,是给中文专业领域造 test suite 式的 ground truth:法律的判决依据链、医疗的诊疗路径、金融的合规检查表。这些环境造一个是一个,造出来就是资产。小团队的生存位置在这里,两三个人在一个垂直领域做深就够。
二,抄协议,别抄规模。PRM800K 的 QC 协议、二元化 rubric 和人机一致率、发布门禁阈值,全部公开,全部能落到中文场景,拼起来就是一套生产级数据质量体系。稀缺的不是方法,是愿意把它们一条条执行到位的团队。
三,别轻信模型自己能造数据的说法。合成数据确实在吃低端需求,但瓶颈从来不在生成,在获取行业原料、处理版权和隐私、构造可验证的工作流。合成管道能造格式,造不出真实世界里的脏数据和边缘案例。懂行的人加上真实的行业资料,这个上游短期内没人替代得了。
这个行业表面上是劳动密集,实际上是信任密集加协议密集。估值 32 亿的公司和估值 3000 万的公司,差别不在人数,在前者每一批数据都有验证链背书,后者没有。今天还在一味扩标注产能的人,五年后回看,处境大概和当年扩客服中心的人差不多。
06常见问题
验证器层到底怎么接活,和现在的标注项目有什么区别?
交付物不一样。标注项目交的是标好的数据,按标注小时和抽检一致率结算;验证器项目交的是能跑起来的环境、测试套件和元裁判,验收口径是 hack 归零率和与人工仲裁的一致性。Anthropic 招聘要求里写明要构建难以被模型投机取巧的测试,这就是这类活的 SOW 原型。报价逻辑也从人头成本换成了防 gaming 的难度。
评测集被污染之后还能不能用?
污染只是第一层问题。OpenAI 抽查 SWE-bench Verified 里模型常做不出的 27.6% 题目,至少 59.4% 的测试用例本身有缺陷,会把功能正确的提交判成错——量具没对着 ground truth 校准过,去污染也救不回来。继续用的前提是重新校验判卷逻辑,并把它和训练数据的供应方彻底隔开。
合成数据会不会吃掉采集和标注业务?
低端需求会被吃掉,这个趋势已经在发生。但合成管道能造格式,造不出真实世界的脏数据和边缘案例,瓶颈在行业原料的获取、版权与隐私处理、可验证工作流的构造。手上有真实行业资料又懂协议校准的团队,短期内替代不了。