AI for Games in the Foundation Model Era
基础模型时代的游戏 AI:一张覆盖游戏全生命周期的地图
游戏里的 AI 能力,真正能跨场景迁移的很少,绝大多数结论只在原来的游戏、引擎、接口和玩家群体里成立。
这篇综述不再按技术路线分类,而是按「AI 的输出被直接拿来做什么」把文献切成六种角色,并为每种角色回答同样三个问题。这个切法让强化学习智能体、世界模型、代码 Agent 和 LLM 评审能在同一张表里比较,也让每一条结论的证据强度暴露出来。
01游戏 AI 的地图为什么必须重画
同一个预训练模型,一周内可以在三个完全不同的岗位上工作,岗位不同,成立的证据也完全不同。
综述开篇的例子很直白:ARC-AGI-3 把模型放进陌生的交互环境,要求它自己摸清规则再行动;Playco 把同一个模型接进引擎工具,生成可玩的游戏原型。模型一样,任务、贡献和验证方式都不一样。过去几十年,博弈搜索、程序化内容生成、玩家建模、自动试玩各自在独立社区里发展,基础模型把它们接到了一起,却没有人把各自的证据放到一起核对。
作者把全文压缩成三条反复出现的结论,每一条都指向评测。
02为什么现在的游戏 AI 结论不能直接复用
能力在变宽,但控制方式、规则、引擎接口、状态表示和玩家语境仍然是每个场景自带的。
- FINDING 1预训练扩宽接口,不消除游戏结构语言、视觉、代码和工具接口让模型能进入更多环节,但模型能表达的内容和游戏能执行的内容仍是两回事。GameNGen 用学出来的神经模拟替代显式规则,依然需要定义好的动作接口和一致性检查。
- FINDING 2玩游戏产出的不只是分数一条轨迹可以成为模拟器的训练数据,可以成为学习型环境里的实验,也可以成为软件修复的诊断证据。轨迹值多少钱,取决于接收它的任务需要哪些信息。
- FINDING 3评测强弱极不均衡有边界的对战和部分学习型环境,评测已经标准化、可执行。持续的创作、运行时适配和真实玩家体验,仍缺少共享的评测基准。
三条合在一起,得出一个工程结论:把一个角色的输出交给另一个角色,不等于能力迁移了。共享一个骨干模型,或者两个组件之间能成功通信,都不构成迁移的证据。
03方法拆解:一张图,五个步骤
综述的方法不是堆文献,而是先定义分类标准,再给每个分类配同一套检验问题。
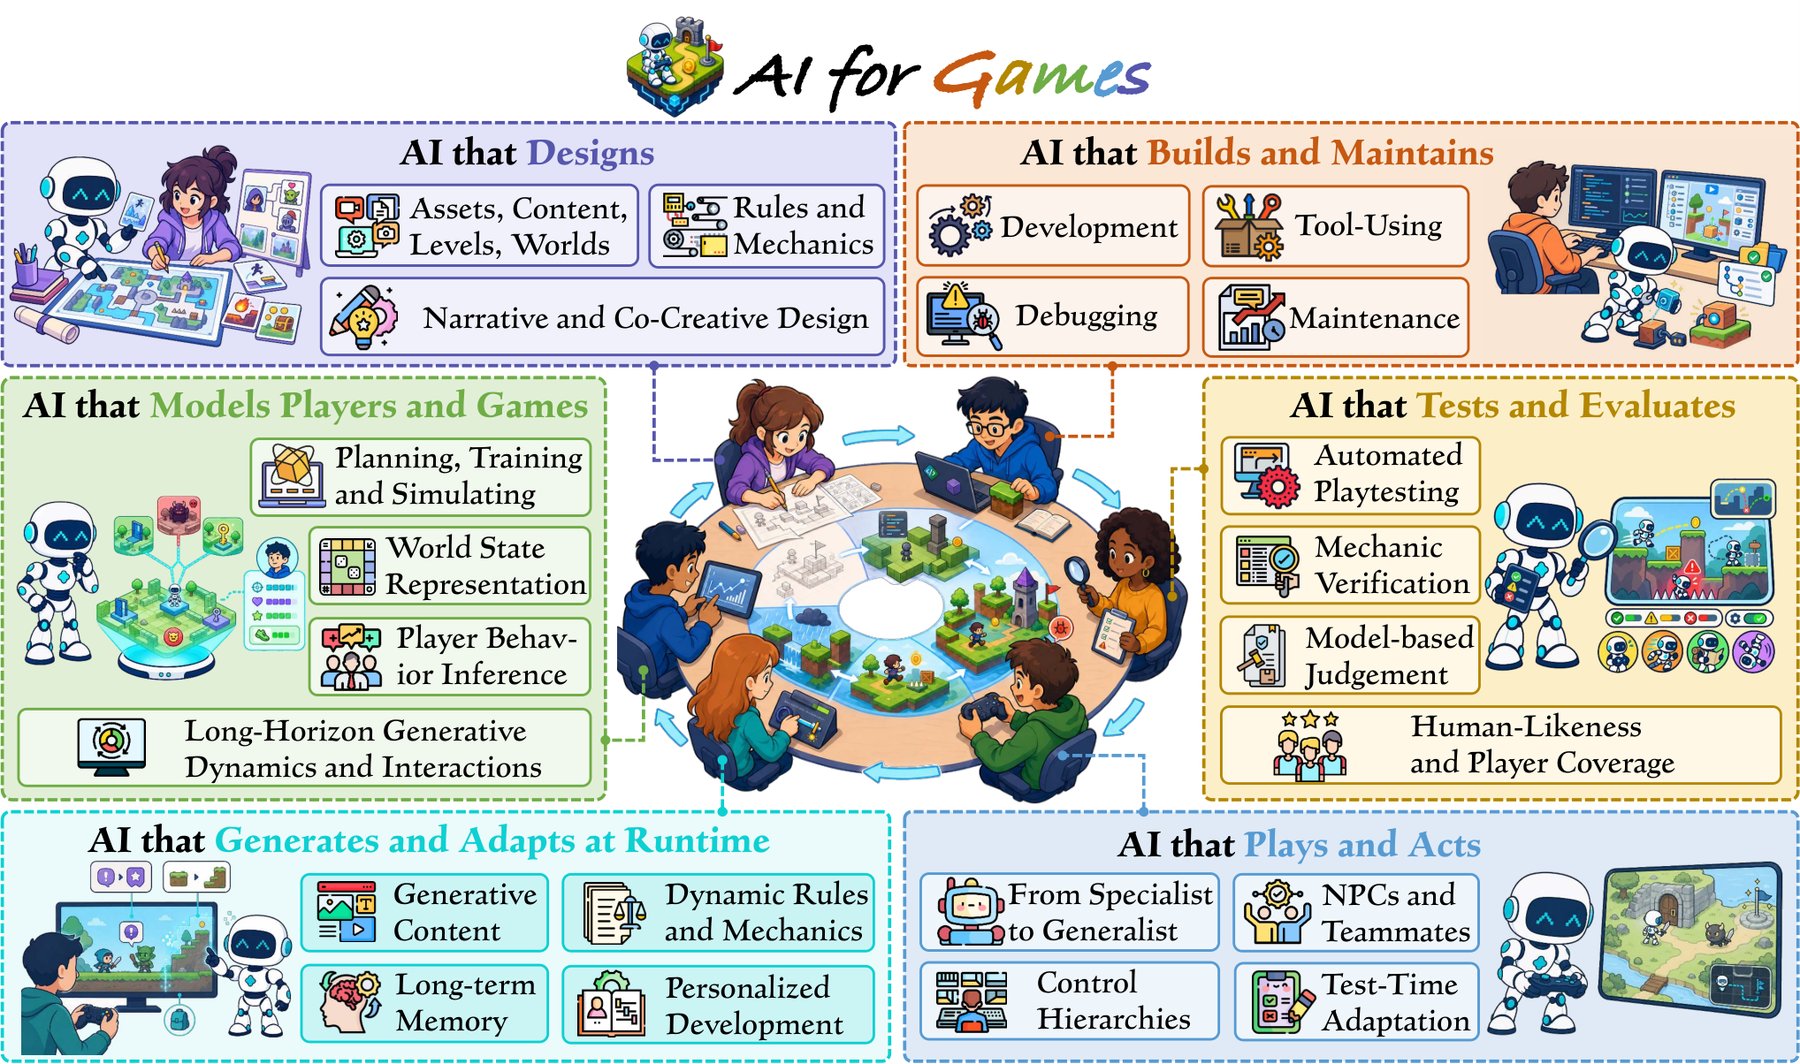
Step 1 按输出的直接用途分角色
玩与行动输出动作、计划和消息;建模玩家与游戏输出状态、转移和玩家预测;设计输出关卡、规则和故事结构;构建与维护输出代码、场景和工程改动;运行时生成与适配输出对话、任务和实时内容;测试与评估输出轨迹、判定和诊断。分类看的是输出用途,不是模型架构,所以同一个系统在不同主张下属于不同角色。
Step 2 给每个角色问同样三个问题
Boundary:游戏或工作流提供了什么,AI 被分配了什么。Transfer and Reuse:哪些能力能迁移,哪些产物能复用,哪些仍然绑定场景。Evidence:评测在使用点上到底支持了什么主张。迁移指换了游戏、引擎、接口、玩家群体或任务后能力还在;复用指一份表示、轨迹、规格、模型或反馈信号被别处消费。
Step 3 用主张反推主角色
一个系统跨多个角色时,归属由它的核心实证主张决定。NPC 策略在主张落在动作与协作时归「玩与行动」,在主张落在会话中对玩家体验的影响时归「运行时」;MarioGPT 提出关卡内容,归「设计」;Play2Code 实现并修复软件,归「构建与维护」。为规划或训练产生的预测与模拟,即使在线运行也留在「建模」。
Step 4 用五个维度比较证据
标准化程度:任务、协议、指标是共享的,还是每个系统自带 demo。执行落地:主张是否用引擎、参考环境或确定性测试验证,而不是只看表面质量。范围与迁移:证据跨了哪些游戏、类型、引擎、接口、玩家群体,测试时究竟变了什么。时程与修订:评估是否覆盖持续交互、反复编辑、回归和交接。外部验证:参照是否独立于被评系统,是否代表目标任务或玩家。综述明确不把这五维压成单一成熟度分数。
Step 5 用三道检查审跨角色连接
兼容:输出是否保留了接收方需要的格式与含义。使用:接收方在评测流程里是否真的消费了它。收益:相对合适的基线,在报告成本的前提下,下游结果是否变好。三者互不蕴含,兼容不等于被使用,被使用也不等于有收益。
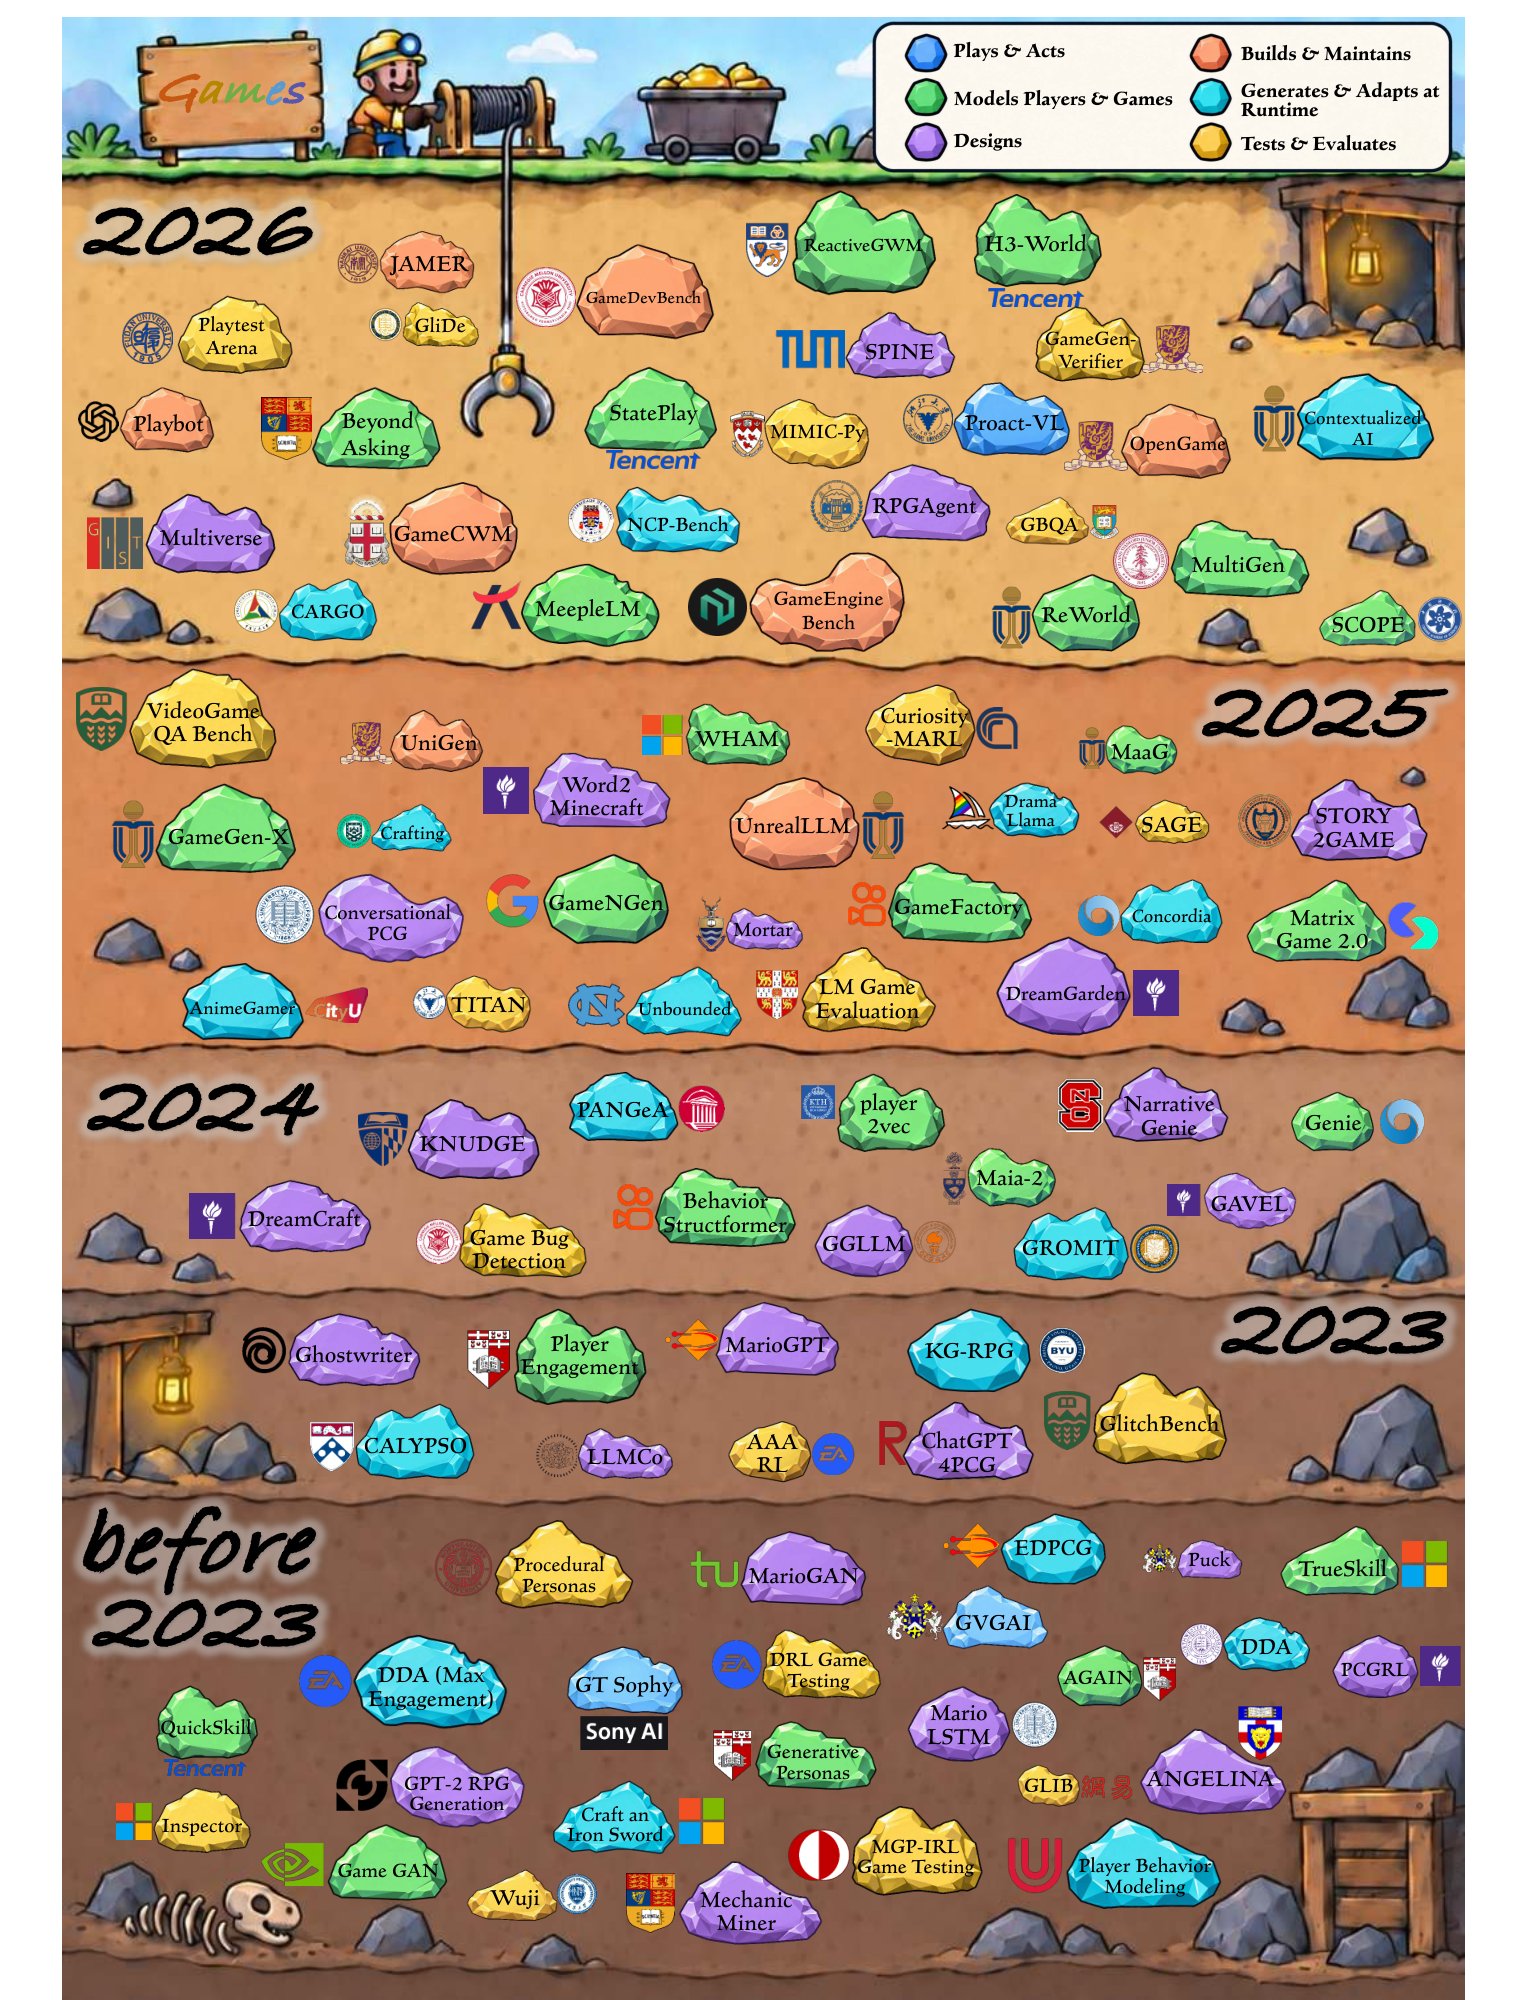
04证据从哪里来:六类角色的评测基础
这是一篇综述,没有自己的实验;它的数据是各角色里最有代表性的基准和它们已发布的结果。
第 3 到 8 章逐角色梳理方法;第 9 章把评测摆到一起,为每个角色定义评测目标和解释边界;第 10 章讨论跨角色连接;第 11 章给出六个开放问题。第 9 章用到的主要数据如下。
| 角色 | 代表基准 | 规模与度量 |
|---|---|---|
| 玩与行动 | GameWorld | 34 款浏览器游戏、170 个任务;18 个模型与接口配置;进度与成功率 |
| 玩与行动 | ARC-AGI-3 | 陌生交互环境;人类相对的动作效率分数 |
| 建模玩家与游戏 | PlayWorld / WorldMark v2 | 9 个交互世界模型;10 个模型、500 个用例的控制精度、纯度、延迟与稳定性 |
| 构建与维护 | GameDevBench / GameCraft-Bench | 333 个 Godot 任务、17 个配置;140 个任务、15 个游戏家族、14 个配置 |
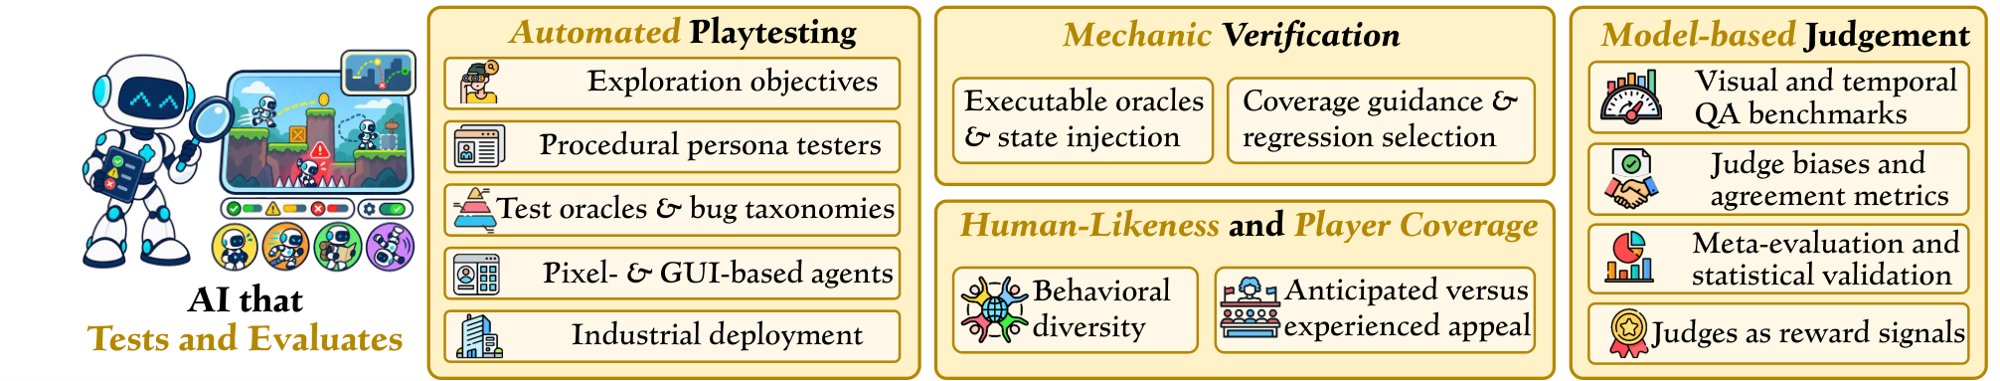
| 测试与评估 | GameGen-Verifier / PlaytestArena / NCP-Bench | 100 个生成网页游戏;32 款游戏;100 个叙事环境 |
每个角色的评测目标都不同:玩与行动看完成度与进度,建模看世界状态保真和策略迁移,设计看有效性与设计师控制,构建看可启动、满足需求、修复与回归,运行时看延迟、一致性与玩家结果,测试看覆盖、已验证缺陷和判定准确率。把它们折成一个分数没有意义。
05结果:四个已经被数字证实的判断
评测数字只在配置好的整个系统上成立,换模型之外的任何一环,结论都会变。
| 基准 | 配置 | 指标 |
|---|---|---|
| GameWorld 成功率 | 最佳模型(Gemini 3 Flash Preview,语义动作) | 21.2% |
| GameWorld 成功率 | 新手 / 专家人类参照(各 1 人) | 55.3% / 77.1% |
| ARC-AGI-3,GPT-6 Astra,High | Standard / Provider Adapter | 54.82 / 99.95 |
| ARC-AGI-3,GPT-6 Astra,Max | Standard / Provider Adapter | 62.71 / 98.55 |
| GameCraft-Bench 总分 | Claude Opus 5(xhigh)/ DeepSeek V4 Pro | 68.44 / 2.15 |
| GameGen-Verifier Acc@5 | 最佳配置 / 覆盖强制基线 | 92.2% / 58.8% |
- FINDING 01
智能体能推进任务,几乎不能完成任务
GameWorld 里表现最好的模型进度 41.9%,成功率只有 21.2%。同一套任务,新手人类参照成功率 55.3%,专家 77.1%,进度分别是 64.1% 和 82.6%。所有 18 个模型配置都低于两位人类参照。进度和完成是两个量:模型常常走到半路就停下,哪怕推理期间游戏是暂停的。两位人类参照各只有一人,只能当作示例,不是新手和专家的总体估计;语义动作解析也没有稳定地赢过直接的电脑操作。
- FINDING 02
基准分数是模型加外壳的分数
ARC-AGI-3 上,GPT-6 Astra 在 High 推理强度下,Standard 外壳得 54.82,换成 Provider Adapter 外壳得 99.95;Max 强度下是 62.71 对 98.55。两种外壳的差别只在如何携带推理状态与管理对话历史。外壳带来的差距,比不同模型之间的很多差距还大。同一张榜上,Standard 外壳下 Claude Opus 5 是 30.16,GPT-5.6 Sol 是 7.78,Grok 4.6 是 2.11。一个分数描述的是配置好的整个系统,不是单独的模型能力。
- FINDING 03
生成的游戏能跑规则,撑不起内容
GameCraft-Bench 在 14 个配置上评完整的游戏工程。Claude Opus 5(xhigh)总分 68.44,核心机制 76.75,内容深度 63.31;所有报告的行里,核心机制分都高于内容深度分。总分跨度从 68.44 一直掉到 DeepSeek V4 Pro 的 2.15,因为无法启动或没有可解析交互轨迹的提交按零分计。模型更稳定地实现可识别的规则,更难实现成体系的进度与内容。
- FINDING 04
测试的瓶颈在判定,注入状态比覆盖更省
GameGen-Verifier 在 100 个生成的网页游戏上,用状态注入加视觉判定与程序断言,最佳配置对专家标注的规格一致率为 92.2%(五次重复运行的 Acc@5),覆盖强制基线只有 58.8%。反面是纯视觉判定:VideoGameQA-Bench 的视觉回归检测最佳准确率只有 45.2%;在 41 小时、19,738 个关键帧的工业素材上,单提示视觉语言基线精确率 0.50、准确率 0.72。PlaytestArena 的原始标准一致率是 84.2%(32 款游戏)。NCP-Bench 里最好的叙事模型,20 轮之后仍无冲突的环境占 42%。
06深入分析:评测哪里最容易被误读
综述对每一个看起来漂亮的数字,都追问了它到底测了什么。
世界模型:好看不等于对
世界模型的保真至少有三个目标:感知质量、机制正确、持久状态。FVD 能发现明显的视觉失败,但不检验具体规则,也不核对隐藏变量;一段漂亮的动画可以伴随错误的血量扣减,一个当下正确的转移之后也可能被遗忘。PlayWorld 对 9 个模型的比较里,SANA-WM 的轨迹有效率是第二高,两项演化得分却停在量表偏低处;LingBot-World2 在可见演化上高于 LingBot-World,在视野外演化上更低。Genie 3 的总分是 2.12(1 到 5 分),轨迹有效率 87.1%。Programmable World Model 在 50 段视频上报告 94% 的计数准确率与 98% 的死亡状态准确率,但它的死亡检查只要求采样帧里有一个可见的死亡角色,不要求是正确的那一个。
迁移:换地图、换模式、换游戏测的是三件事
换地图测规则不变下的稳健性,换模式测对命名规则变体的适应,换游戏测被评测行为或模型功能的迁移。SIMA 在留出游戏上评估指令行为,SCOPE 在多款 FPS 上测动作条件生成,二者都跨游戏,但后者没有证明策略学会了新的取胜方法。GameFactory 的新视觉场景证明外观与控制的迁移,没有恢复每个游戏原本的机制。零样本、检索目标演示和目标游戏微调,测的是不同形式的迁移;公开的代码、攻略和基准仓库与预训练数据的重叠是未知量,既不能当作污染的证据,也不能当作干净划分的证据。
评审:自偏好和奖励黑客
模型评审倾向于偏好自己的输出,针对不完美验证器优化会奖励捷径。GameGen-Verifier 的状态注入能检查局部机制,却绕过了到达该状态的路径;Play2Code 的试玩能发现路径,却受限于试玩者去过的地方。只针对其中一种反馈做修复,另一类失败原封不动。重复运行同一个评审、换一个提示词,都不构成独立验证。
人类研究与可复现
同一批玩家反复开关卡不是独立被试;部署的日历时长不等于每个玩家的多会话暴露。个性化关卡生成里,两组玩家在拿到个人历史之前,初始关卡的生成策略就已经不同,之后的差异不能全算给个性化。可复现的评测需要写明模型与引擎版本、提示词、观察与动作接口、工具权限、随机设置,以及重试与择优预算。
综述自身的边界
第 10 章是对代表性系统的定性综合,不给各类跨角色连接排序,也不衡量成熟度。第 13 张表列出的是「待验证的下游结果」,不是每个系统都已完成的结果。作者提出的灰盒加生成式渲染工作流(代码 Agent 先做可执行灰盒,状态条件视频模型负责外观),在完整生产引擎里仍然是研究方向,轻量引擎的演示不能证明 UE 或 Unity 项目的可靠生成与维护。
07开源与资源
综述配了一个持续更新的资源库,把 400 多篇文献按角色整理成可检索的索引。
- GitHub 仓库:Eurekaleo/awesome-ai-for-games
- 项目网站:eurekaleo.github.io/awesome-ai-for-games
- 论文附录 A 的系统索引记录每个系统的主次角色与测试手段;附录 B 收录游戏示例与交互演示。
08对数据与评测行业的意义
游戏是 Agent 评测最干净的试验场:规则清晰、反馈可观测、状态可检查,所以它暴露出的评测问题,在其他领域只会更严重。
第一,任务数据必须带环境、动作接口和状态,不能只带题面和答案。论文的结论是,一条轨迹对不同接收方价值不同,动作要配观察,设计要配需求,画像要配语境。我们交付的任务数据,每一条都应该同时交付可复现的环境版本与动作语义,缺任何一项,下游就会用错。
第二,验证器要执行,不要只打分。FINDING 04 说明,状态注入加程序断言的一致率达到 92.2%,纯视觉判定在视觉回归上只有 45.2%。凡是规则能写成断言的部分,一律交给引擎检查;评审模型只处理断言写不出来的部分,并且必须有独立来源的参照,不能让生成器和评审共用同一套盲点。
第三,评测报告必须把外壳当成一等变量。54.82 到 99.95 的差距说明,只报模型名的榜单没有信息量。每个榜单分数都要附上外壳、工具权限、重试预算和推理强度,并且单独报告外壳消融。
第四,要区分进度和完成、典型尝试和择优结果、单会话和持续使用。GameWorld 的 41.9% 对 21.2% 就是这个区分的价值。我们的评测数据集默认提供分层指标,不提供单一总分。
第五,真实缺口在持续性:持久状态、反复修订、持续适配和真实玩家覆盖,这几项现在都没有成熟基准。这些正是任务数据和验证器最缺的地方,也是我们优先建设的方向。
09引用
@article{luo2026aiforgames,
  title   = {AI for Games in the Foundation Model Era},
  author  = {Luo, Meng and Li, Yanlin and Li, Hao and Lin, Hongzhan and Zhou, Pengfei and Ju, Tianjie and Zhang, Ran and Jin, Yeying and Lee, Mong-Li and Hsu, Wynne},
  journal = {arXiv preprint arXiv:2609.16679},
  year    = {2026}
}