Idea2Story
An Automated Pipeline for Transforming Research Concepts into Complete Scientific Narratives
01概览:把读论文从在线推理搬到离线建图
Idea2Story 的论点只有一句:文献理解是可以预先算好的资产,不该每次任务都现算一遍。
现有的自动科研 Agent 在运行时检索、阅读、总结大量高度重叠的论文,再靠开放式生成加试错去探索方法与实验设计。Idea2Story 把这一步拆成两段:离线阶段把顶会论文和评审意见沉淀成方法论知识图谱,在线阶段把用户含糊的想法对齐到图谱里的研究范式,检索并组合出研究模式,再经过评审循环修订。
02为什么要解决这个问题:运行时读文献的三笔账
在线现算的执行范式,把已有的知识反复重读一遍,成本、上限和可靠性三处同时吃亏。
- COST成本高、耗时长论文指出,完整跑一遍流程常要数小时,最长达 15 小时才能从构思走到实验;Agent Laboratory 中,文献综述与实验规划就占了推理时间的很大一块。
- CONTEXT上下文窗口是硬上限文献长、异质、冗余多。模型要在有限窗口里维持连贯推理,OpenHands、SWE-Agent 在真实代码库上表现有限,MLE-bench、SciCode 上完成率偏低,根因都指向对层级依赖和结构约束的推理不足。
- RELIABILITY幻觉与漂移叠加Agent Laboratory 的自动评审明显高估论文质量;Kosmos 会编造不透明的指标,把统计显著混同于科学价值;长程执行还会出现目标漂移。
创意本身也有问题。Si 等人的研究显示,LLM 想法初筛时显得新颖,落地实现后却不如人类想法;生成越多,输出越相似,有效多样性下降。Idea2Story 的回应是:与其让模型临场发挥,不如让它在一个已被评审验证过的方法结构上检索与组合。
03方法拆解:两阶段,五个动作
离线阶段负责把论文变成方法单元和图,在线阶段负责检索、组合和评审,两段之间只靠知识图谱衔接。
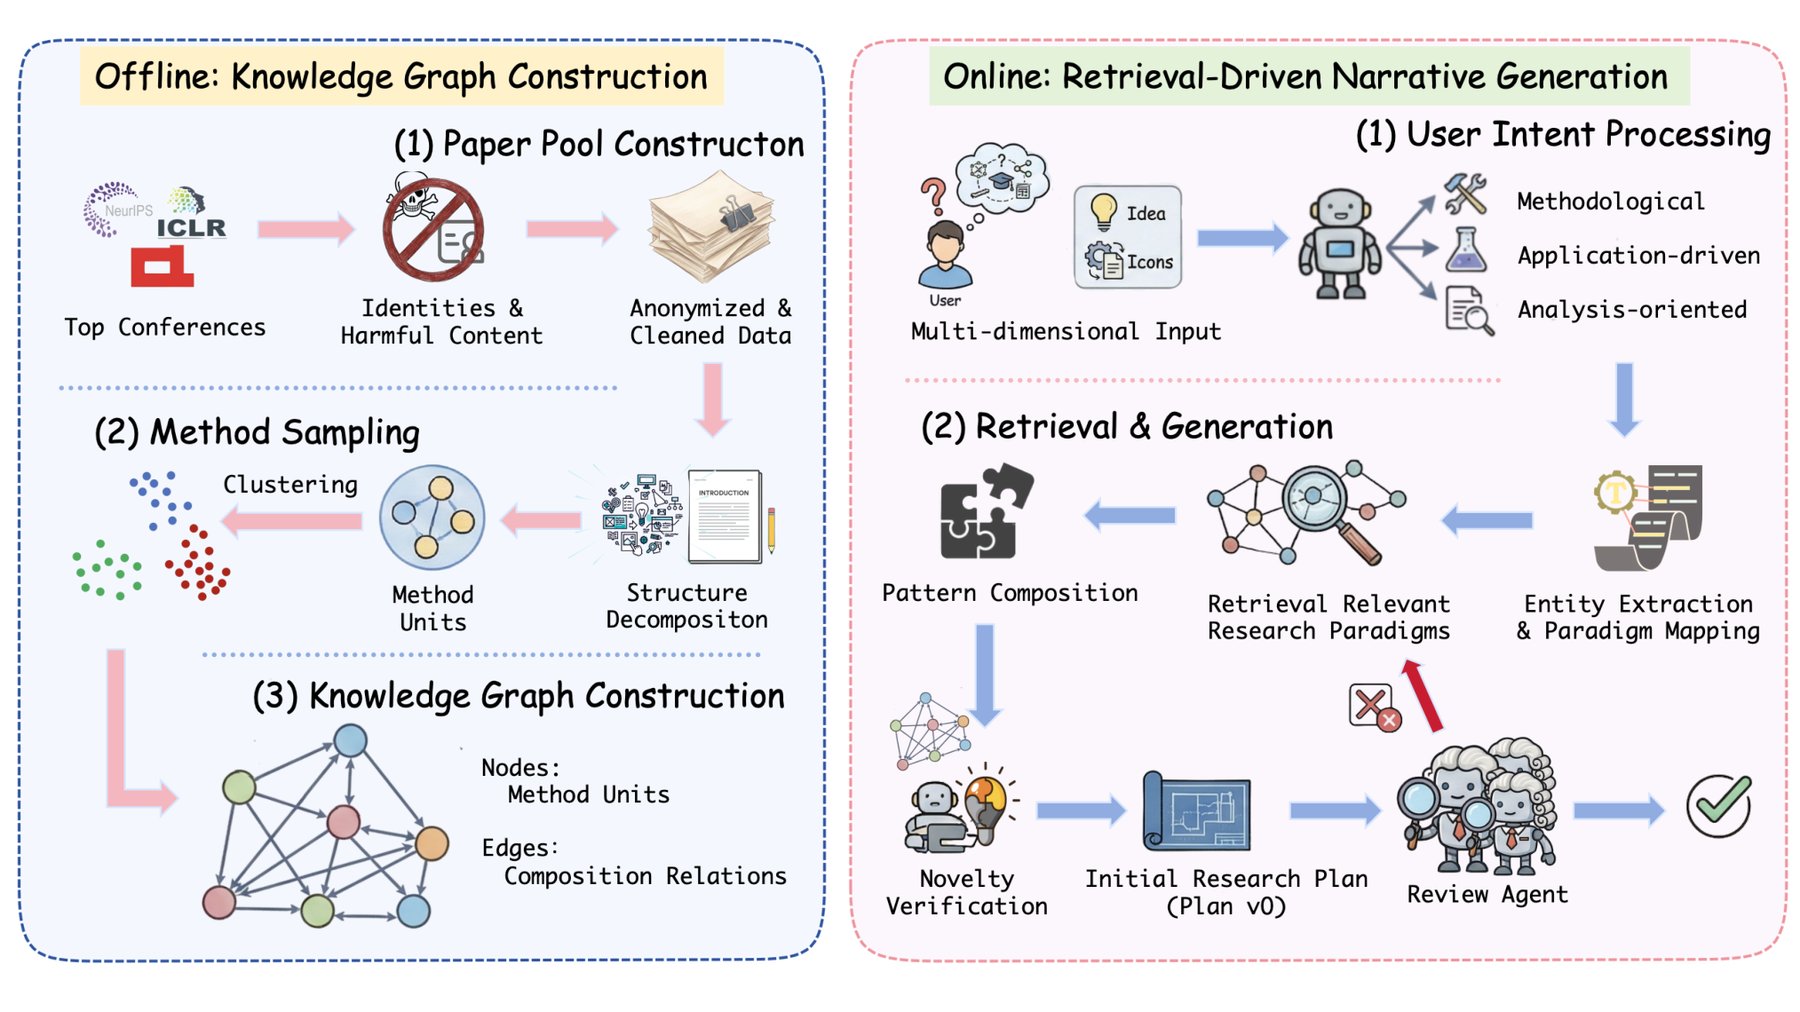
步骤一:构建论文池
语料来自顶会的录用论文及其同行评审,取最近三年,约 5,000 篇 NeurIPS、8,000 篇 ICLR。每篇保留全文和评审材料。入库前先做匿名化,去掉作者、评审人的姓名、单位、邮箱和身份指涉;评审内容再过一遍安全过滤,剔除攻击性和有毒语言。
步骤二:抽取方法单元
抽取器把论文拆成引言、方法、实验三部分,各取一类信号:引言给出研究动机和问题定义,方法给出建模假设、学习目标、架构与优化策略,实验给出机制如何落地和评估。方法单元的定义很克制:它是“问题如何被提出或解决”的自足描述,抽掉具体实现和实验配置;数据集选择、超参调优、工程优化默认排除,除非它们改变了问题定义、模型结构或学习目标。多数论文产出一个或少数几个单元,并被规范化为不可再分的元方法,以及描述单篇论文内多个单元如何组合的组合级模式。
步骤三:聚类出研究模式
每篇论文由其方法单元的嵌入表示;先做非线性降维,保留局部语义邻域,再用 DBSCAN 做密度聚类。每个簇对应一种反复出现的研究模式。
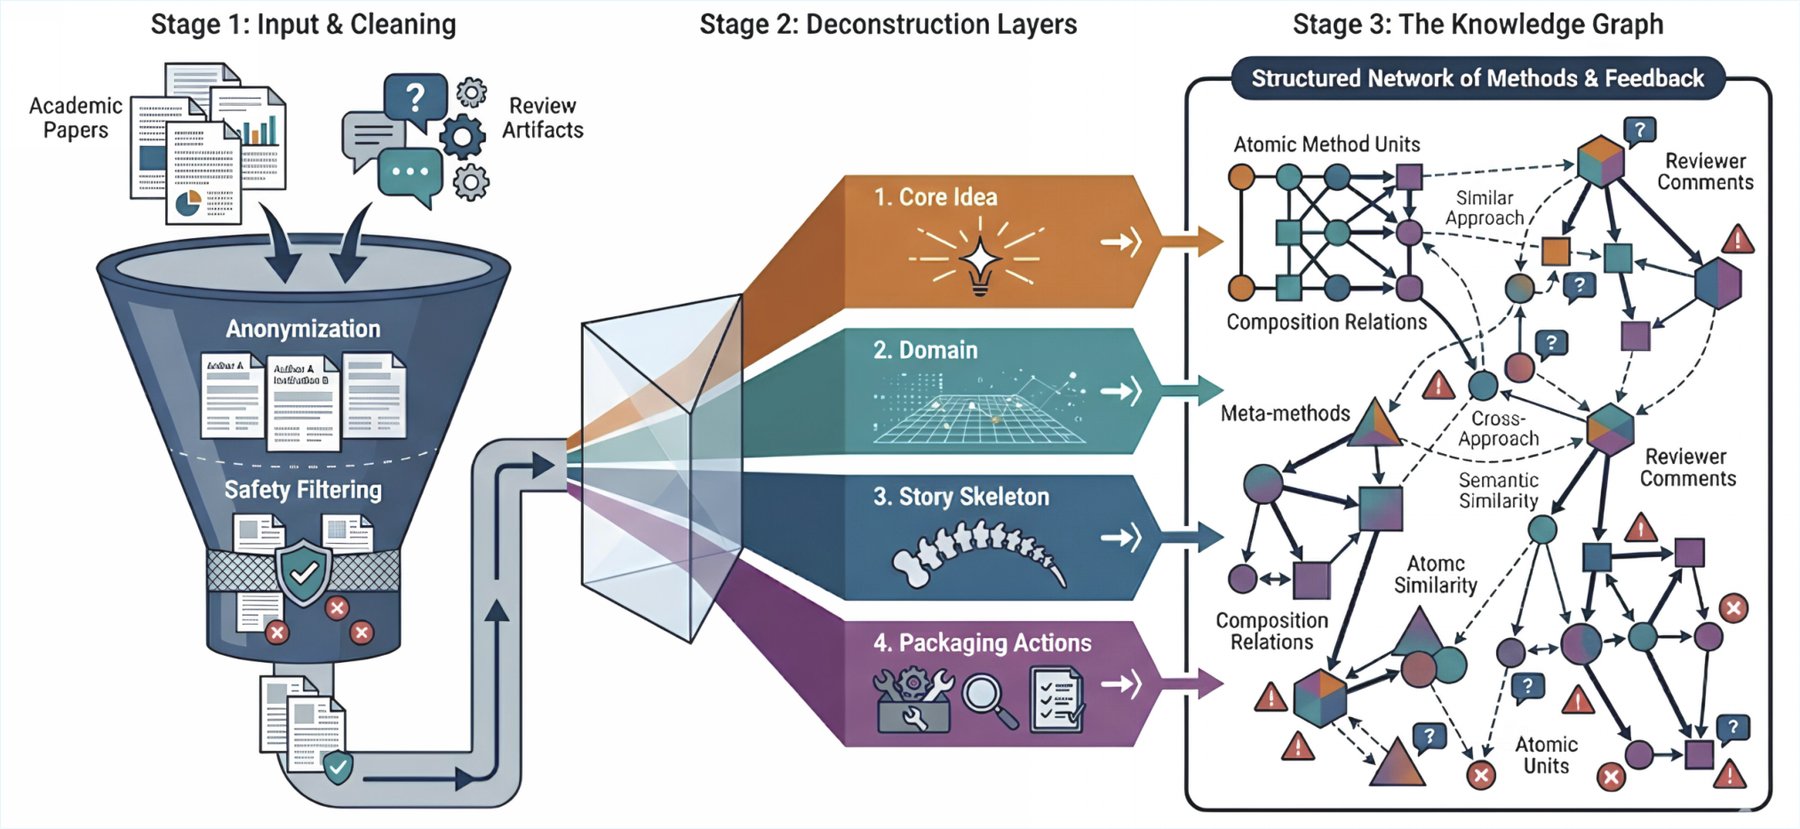
步骤四:建方法论知识图谱
图是有向图,节点是规范化后的方法单元或元方法,语义相近的单元合并到同一个元方法下。边来自真实论文:同一篇论文里联合使用的两个方法单元之间加一条有向边。边因此是“在录用论文里确实一起用过”的经验证据,不是人工设定的假想关系。图同时编码两层结构:可复用的方法元素,以及由共现统计导出的组合约束。
步骤五:在线检索与评审修订
给定自然语言想法,系统对每个研究模式计算多视角加权得分,权重固定。想法级:与语料中相似想法的语义相似度,按模式关联的想法聚合。领域级:想法与研究领域的相关度,乘以由图谱得到的有效性信号。论文级:想法与实例化该模式的论文的相似度,乘以由评审元数据得到的质量权重。最后按总分降序排列。
候选模式随后进入评审循环:一个 LLM 扮演评审,按技术严谨性、相对已有文献的新颖性、问题与方法的对齐度打分并给出修改建议。新颖性不足,就重组兼容的方法单元或换同一模式族内的另一种实现;可行性或表述有问题,就改问题定义或方法结构。只保留让评审分提高的修订,否则回滚到上一版,直到评审认可或不再有提升。
04实验设置与数据
这是一份小规模的定性评估:13K 篇论文做语料,3 个外部合作者给的想法做测试,对手是同一个模型的直接生成。
语料即上述约 13K 篇论文及其评审。生成端使用 GLM-4.7 作为语言模型底座。基线是直接 LLM 生成:同一个模型不经过模式建模和检索,直接写出完整的研究故事。测试输入是由一位外部合作者给出的 3 个研究想法。为减少评价偏差,两边产出的研究故事交给不参与生成的 Gemini 3 Pro 评判,评判时不告知生成方式,比较维度是新颖性、方法实质和整体研究质量。
05结果:重构问题的能力来自结构化的模式
论文给的是案例级证据:方法单元能干净地分层,图谱有可读的结构,同一句模糊输入得到更深的问题重构。
| 维度 | Idea2Story(IntentDiff) | 直接 LLM(EcoIntent) |
|---|---|---|
| 问题定义 | 把意图分类从静态文本预测改为动态的结构化推理,意图理解是受结构约束的演化过程 | 常规多分类:查询加会话上下文,输出预定义意图标签 |
| 研究缺口 | 现有方法孤立看待查询,忽略电商结构先验;通用词表难处理长尾领域词汇;尚无工作把扩散式精炼与结构图嵌入结合 | 上下文孤立,点击等行为信号利用不足;扁平标签假设忽略电商分类层级 |
| 方法骨架 | 迭代去噪意图表示的扩散分类器;基于 VQ-VAE 变体的上下文感知离散分词器;去噪时引入预训练商品图嵌入 | BERT 文本编码器、轻量 GNN 聚合行为交互图、层级对比学习预测头;LoRA 参数高效适配 |
测试输入均为“I want to build an e-commerce agent that can better understand user intent.”表格节选自论文 Table 1。
- FINDING 01
一篇论文可以被压成“问题、解法、故事、应用”四个槽位
案例取自《Learning Dynamics of LLM Finetuning》。抽取结果把基础问题(理解具体训练样本在微调中如何影响模型预测)、解法模式(逐步分析潜在回答间影响累积的框架)、故事(用学习动力学统一解释训练行为)、应用(改进对齐、诊断幻觉)分开存放,且不绑定具体数据集和优化配置。原因是抽取只取方法层信号并剔除实现细节,所以单元能跨论文比较、复用和组合。
- FINDING 02
图谱是枢纽加辐条的结构,模式节点承担跨领域桥梁
Figure 4 显示:少数高频领域连接大量论文和研究模式,反映研究活动分布不均,也标出了方法复用的中心。许多模式同时连接多个领域,论文节点通常只属于单一领域。原因是模式是对论文的上层抽象,所以能连起原本联系很弱的领域,检索也不必依赖单一领域或单篇论文的相似度。
- FINDING 03
同一句模糊输入,Idea2Story 重写了问题,基线只是加组件
Idea2Story 产出的 IntentDiff 把意图分类重构为结构演化,落在生成式精炼、结构先验、演化表示上;直接 LLM 产出的 EcoIntent 仍停在传统分类框架里,靠叠加上下文建模和层级目标做出一个更强的系统。差别来自模式检索给了模型一个已被验证过的高层问题形态,而不是让它从零拼装。
- FINDING 04
外部评审在全部评估案例上倾向 Idea2Story
Gemini 3 Pro 不知道生成方式,按新颖性、方法实质、整体质量比较,结果在所有评估案例上一致偏向 Idea2Story。直接生成的故事停在高层抽象,方法落点少,依赖相对标准的技术;Idea2Story 的问题框架更清楚,方法结构更具体,新颖性信号更强。评估只有 3 个案例,这个结论的边界也在这里。
06深入分析:边界与局限
这篇工作证明了方向可行,没有证明效果的量级。
第一,评估规模小。3 个想法、1 个领域案例、1 个 LLM 评判者,没有人工评审,没有成功率、成本或耗时的定量对比。引言里强调的“降低成本、缓解上下文瓶颈”,论文给的是机制论证,没有实测数字。第二,打分的权重、降维与 DBSCAN 的具体参数,正文只给了形式化定义,未公布取值。第三,评审循环的评判者仍是 LLM,而论文自己在相关工作里承认,LLM 评审偏重技术正确性、低估新颖性,且在作者反驳后会不合理地抬分。回滚机制只保留评审分提高的修订,约束了漂移,却把评判质量上限锁在评判者本身。第四,系统在当前版本只做到“研究模式”这一层,实验驱动的验证、数据集选择、论文全文生成都被列为未来工作:把实验结果回填到研究故事,让方法设计和实证验证互相提供反馈。
07开源与资源
代码已公开,论文没有列出语料或图谱的数据发布。
- 代码:github.com/AgentAlphaAGI/Idea2Paper,作者团队为 AgentAlpha Team。
- 论文:arXiv:2601.20833,HTML 全文。
- 数据:图谱所用的论文与评审来自公开顶会,论文未给出整理后的方法单元数据集下载入口。
08对数据与评测行业的意义
Idea2Story 证明了一件事:高质量的专家判断,只要被结构化成单元和关系,就能变成模型每次调用的基础设施。
- TASK DATA任务数据的价值在抽象层,不在原文方法单元刻意去掉数据集、超参和实现细节,保留问题与解法。做任务数据同理:一条样本的价值是它携带的可迁移结构,我们按“问题、解法、验收”拆开标注,而不是堆原始文本。
- VERIFIER评审信号是最稀缺的验证器原料论文把同行评审作为质量权重和关系修正的信号,说明评审意见比论文本身更接近验证器。验证器要从真实的专家裁决里学,而且要保留分歧与理由,不能只留一个分数。
- EVALUATIONLLM 当裁判不能单独成立论文自己的相关工作已经列出 LLM 评审的系统性盲点:低估新颖性、被反驳抬分。评测必须有专家标注的校准集,并且让评判者与生成者分离。Idea2Story 用 Gemini 3 Pro 做外部评判是对的方向,3 个案例远不够下结论。
- GRAPH经验证据的边,比人工设定的边可靠图中的边只来自真实录用论文里的联合使用,是可审计的数据。我们做数据资产同样坚持:每条关系都要能回溯到具体来源,可复核,可更新。
这篇论文的结论也给了一条行业判断:自动科研的瓶颈不在模型更会写,而在可复用的结构化知识与可信的评测。把专家判断提前沉淀成资产的团队,会在成本和稳定性上同时领先,现算的团队会一直为重复阅读付费。
09引用
@article{xu2026idea2story,
  title   = {Idea2Story: An Automated Pipeline for Transforming Research Concepts into Complete Scientific Narratives},
  author  = {Xu, Tengyue and Qian, Zhuoyang and Liu, Gaoge and Ling, Li and Zhang, Zhentao and others},
  journal = {arXiv preprint arXiv:2601.20833},
  year    = {2026}
}