Story2Proposal
A Scaffold for Structured Scientific Paper Writing
01概览:长文档质量取决于约束放在哪里
论文写作的难点是让叙事、实验证据和图表三者始终对齐。先自由生成再事后校验的管线做不到这一点,把约束写成一份全程共享的契约才做得到。
Story2Proposal 由 AgentAlpha 团队提出。它把一个研究故事(叙事描述、实验证据、背景信息)转成完整论文稿,由 Architect、Writer、Refiner、Renderer 四个 Agent 在一份持久共享的「视觉契约」下接力完成,评估 Agent 在生成过程中持续反馈并改写契约。实验取自 Jericho 研究语料,由十位独立专家按八个维度打分。
02为什么要解决:先写后查,结构必然漂移
无约束生成的错误会沿章节累积,等到事后校验时,漂移已经发生。
论文是跨章节一致性要求最高的长文本。引言里声明的贡献,方法章节要给出细节,实验章节要逐条验证,相关工作又不能与方法互相矛盾。直接提示生成没有任何中间控制,单 Agent 长文生成缺少分工,大纲方法只给高层结构,三条路线都守不住这些约束。后果有四类:章节漂移、声明与实验对不上、引用与论点脱节、方法与实验设置互相矛盾。
- PROBLEM 01结构漂移后面的章节逐渐偏离最初的问题设定。没有共享状态,每一节只对自己负责。
- PROBLEM 02视觉产物丢失图和表在提示词里只是文本标记,迭代改写时被丢掉或重复,引用也随之失效。
- PROBLEM 03校验太晚生成结束后才检查,错误已经扩散到多个章节,修复成本高于预防成本。
03方法拆解:一份契约,四个生成 Agent,一组评估 Agent
Story2Proposal 把结构和视觉义务显式写进契约状态,每个 Agent 都对着同一份状态工作。
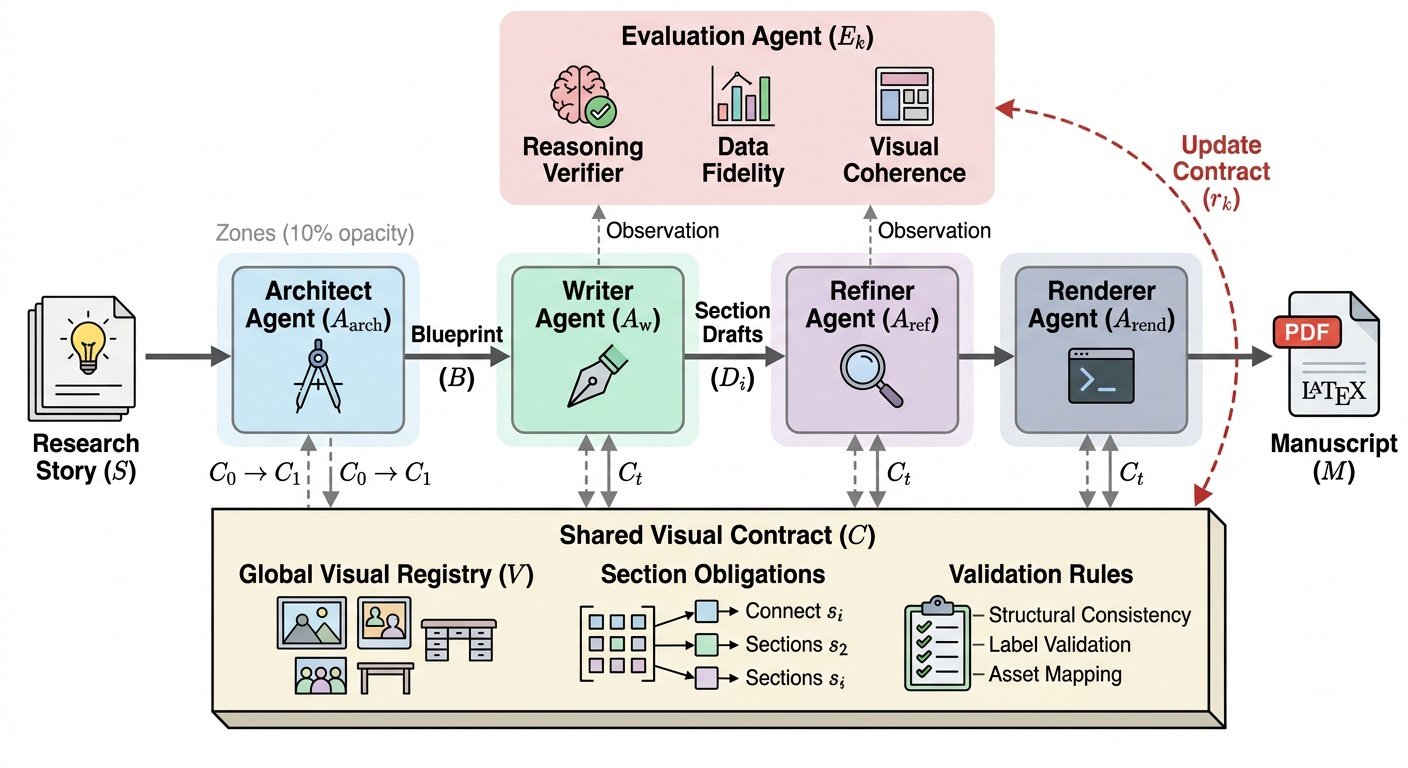
第一步:契约本身有三层
全局视觉登记表记录每个图表的类型、语义描述、标准标签和预期引用位置。章节级义务规定每一节必须出现哪些图表。校验规则要求标签唯一、交叉引用有效、图表描述与上下文对齐。
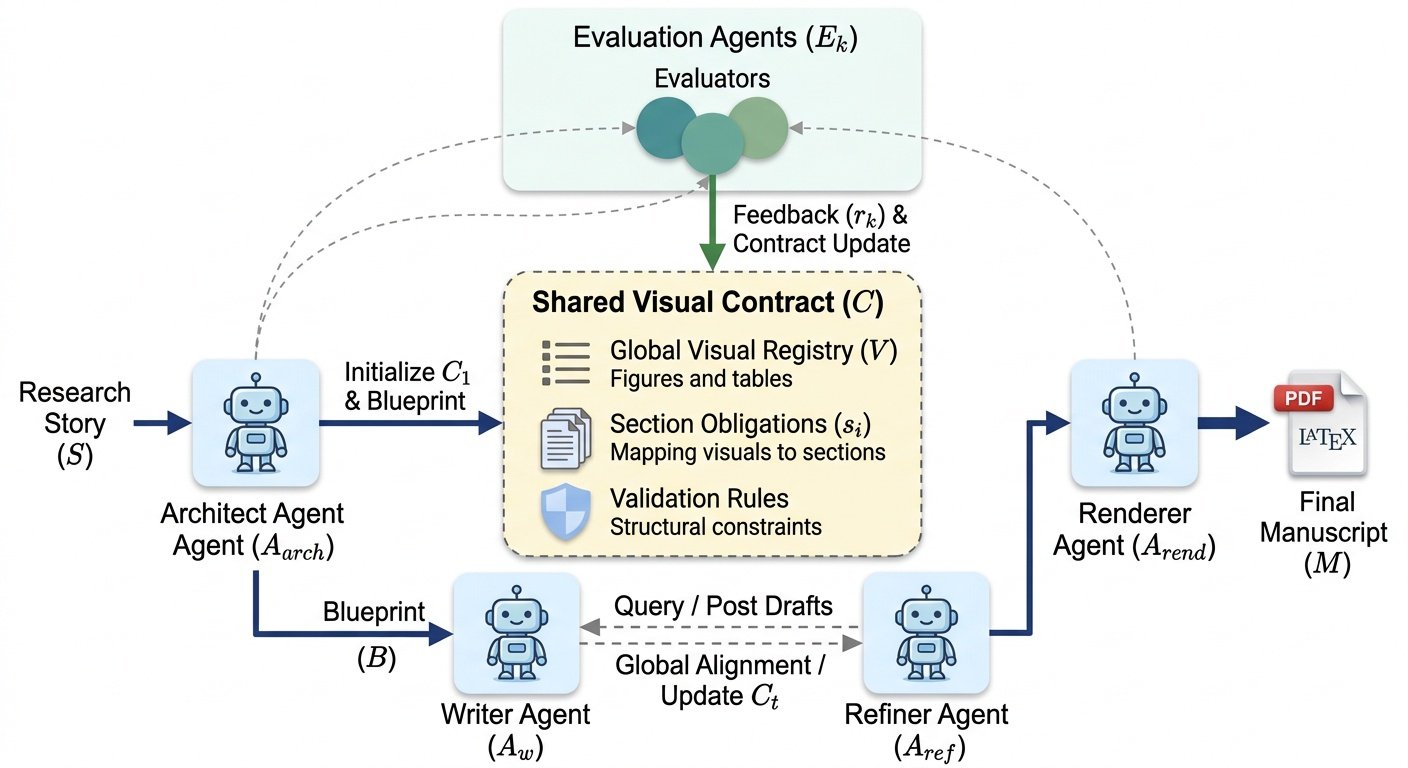
第二步:Architect 搭骨架
Architect 把研究故事拆成有序章节,为每节写出论证提纲、关键声明和支撑证据,识别候选图表并登记进契约,再把每个图表映射到它必须出现的章节。
第三步:Writer 按契约起草
Writer 逐节起草,视觉标记和引用标识必须与契约登记一致。图表只能引用已登记项,不能自行再造标记。
第四步:Refiner 做全局对齐
Refiner 压缩重复解释,统一各节术语,确认每个被引用的图表在周围文字里得到恰当说明。发现不一致时,通过评估反馈触发契约更新。
第五步:Renderer 做确定性校验
Renderer 输出稳定的 LaTeX,解析全部视觉引用,标准化标签,并对照契约校验交叉引用。每个登记图表必须出现一次,且引用一致。
第六步:评估 Agent 边写边改契约
评估 Agent 各管一个维度:推理验证、数据保真、视觉一致。它们对中间产物给出问题、置信度和修正建议,聚合后更新契约。典型例子:发现某个图引用缺少说明,契约就新增一条规则,要求该引用必须配一段解释。这就是生成-评估-适配循环。
04实验设置与数据
评审以人为准,因为自动指标测不出文档级的推理连贯性。
四个底座是 GPT、Claude、Gemini、Qwen,使用同一条流水线配置,从同一份研究故事生成整篇稿件,所有对比系统使用相同提示与输入。每个条件配十位独立专家,对完整稿件评分,八个维度包括结构完整性、写作清晰度、方法严谨性、实验实质、引用规范、可复现性、格式稳定性和视觉传达,聚合为单一专家分。
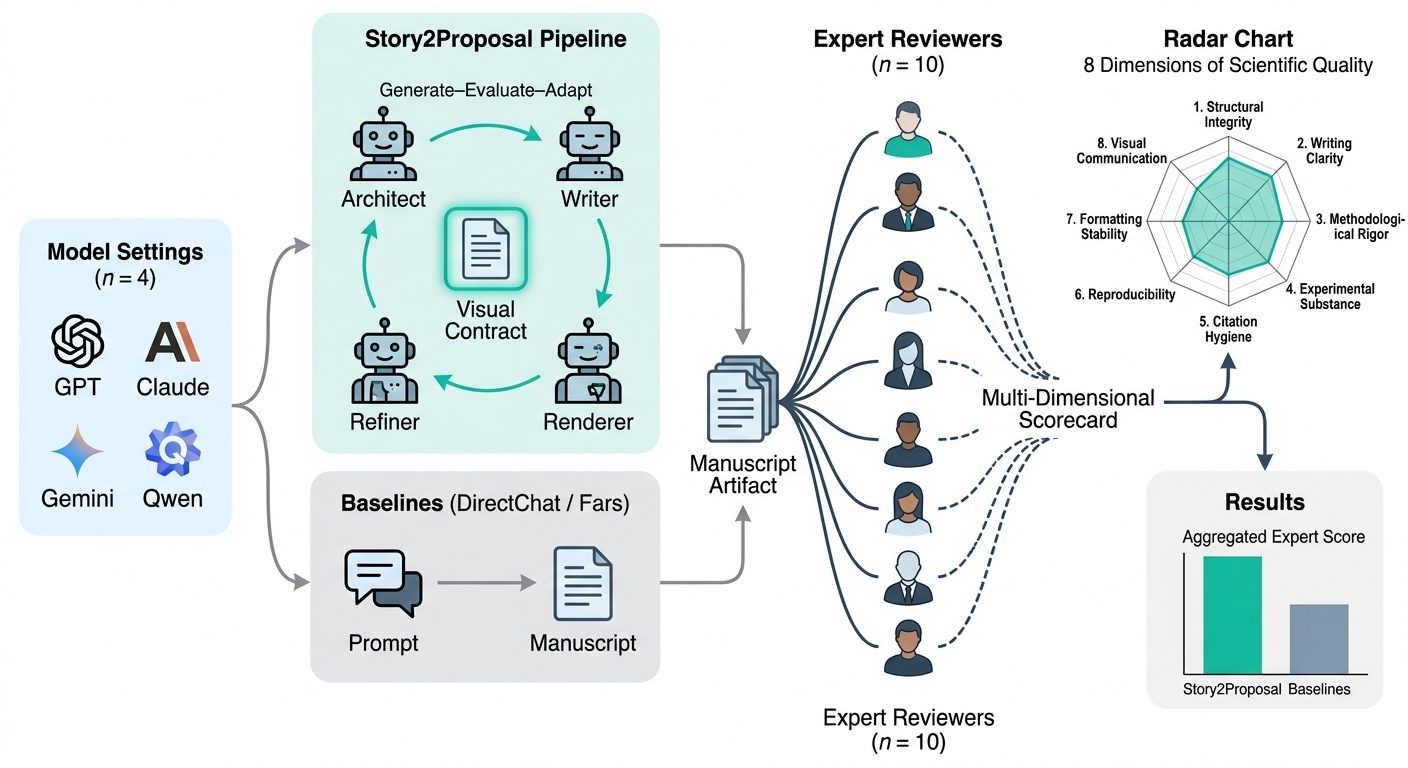
两组实验。第一组对比 DirectChat,即无契约、无多 Agent 的单阶段提示生成。第二组对比结构化生成基线 Fars,在四篇基准论文上进行:Escrowed Batch Reveal、Symbolic Execution、Hazard-Signature Tombstones、Poisoning LLM-Induced Rules。
05结果:四个底座全部大幅领先
| 模型底座 | Story2Proposal | DirectChat | 领先 |
|---|---|---|---|
| GPT | 5.962 | 4.078 | +1.884 |
| Claude | 6.153 | 3.864 | +2.289 |
| Gemini | 6.257 | 3.934 | +2.323 |
| Qwen | 6.207 | 3.975 | +2.232 |
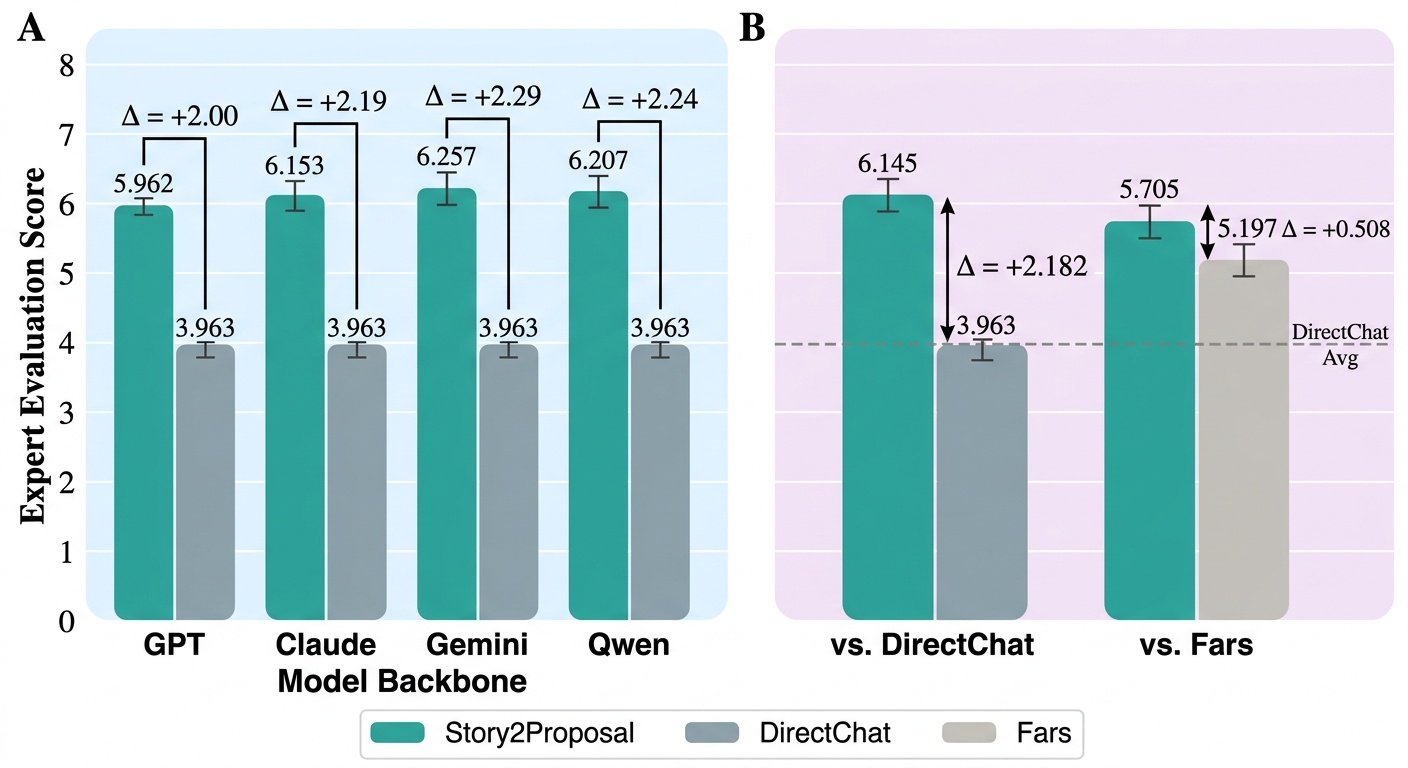
| 平均 | 6.145 | 3.963 | +2.182 |
| 基准论文 | Story2Proposal | Fars | 领先 |
|---|---|---|---|
| Escrowed Batch Reveal | 5.459 | 4.928 | +0.531 |
| Symbolic Execution | 5.886 | 5.638 | +0.248 |
| Hazard-Signature Tombstones | 5.600 | 4.709 | +0.891 |
| Poisoning LLM-Induced Rules | 5.876 | 5.511 | +0.365 |
| 平均 | 5.705 | 5.197 | +0.508 |
- FINDING 01
增益来自架构,与底座无关
四个底座的领先幅度在 +1.884 到 +2.323 之间,全部为正。DirectChat 在四个底座上只有 3.864 到 4.078,Story2Proposal 抬到 5.962 到 6.257,底座之间的差距反而被压缩。原因是结构职责从模型身上剥离,交给契约和流水线承担,模型只负责局部推理与内容生成。
- FINDING 02
对强结构基线仍然领先,幅度收窄到 +0.508
Fars 已使用结构化模板,平均 5.197。Story2Proposal 取得 5.705,四篇基准论文全部更高。最大差距出现在 Hazard-Signature Tombstones,+0.891;最小在 Symbolic Execution,+0.248。模板解决了基础结构问题,剩下的差距来自持续校验和图文对齐,这正是契约的作用。
- FINDING 03
领先在每一位评审身上都成立
Story2Proposal 的评分高于 DirectChat,在十位评审的每一列、每个底座下都是如此。以 E8 为例,GPT 下从 4.23 升到 7.60,Claude 下从 3.92 升到 7.81。E3 的 DirectChat 基线本来就高,约 6 分,增幅相对最小:GPT 下 5.97 到 6.98,+1.01。基线越低,契约的收益越大。
- FINDING 04
最明显的收益在结构完整性与格式稳定性
专家反馈指出,契约生成的稿件章节组织更一致,布局错误更少,实验描述更清楚。对 Fars 的比较中,实验章节里图表被一致引用并放在正确位置,图文对齐更强。机制很直接:图表登记在带标识符和位置义务的注册表中,Agent 引用已登记项,不再重新生成标记。
06深入分析:机制、边界与局限
契约有效,是因为错误被拦在传播之前;契约的上限,由评估 Agent 的判断力和输入故事的完整度决定。
机制一:每一阶段先更新并校验契约,再进入下一阶段。这与语法约束解码在生成中途发现问题的思路一致,只是作用在文档层级。结构错误不会跨章节累积。
机制二:职责外化。DirectChat 要求模型同时处理推理、格式、章节结构和图表引用,任务复杂度被叠加。Story2Proposal 把后三项交给契约与专门 Agent,模型只管局部内容。底座换了,结构行为不变。
消融。这一版没有做消融实验。契约、评估循环和四 Agent 分工各自的贡献没有被拆开测量,增益是整体架构的效果。
局限一:对 Fars 的领先幅度明显小于对 DirectChat 的领先幅度。最大收益出现在替换无约束生成的场景。
局限二:评估 Agent 漏掉细微的推理缺陷时,契约不会触发修正。稿件可以结构合规而论证薄弱。需要更丰富的评估信号和更专门的批评模块。
局限三:契约约束结构与视觉义务,不生成缺失的科学证据。研究故事残缺,稿件会逻辑自洽但内容有洞。需要检索或证据验证环节在生成前补全输入。
此外,论文声明稿件正文与插图主要由 Story2Proposal Agent 自己生成,人类只负责系统设计和实验整理。
07开源与资源
论文原文与 HTML 全文见页首按钮,版本为 arXiv:2603.27065v1,2026 年 3 月 28 日提交,归类 cs.CL。论文正文没有给出代码仓库或数据集发布地址,Jericho 研究语料也没有给出获取链接。实验的原始分数在论文 Table 2 和 Table 3 中按评审逐列给出,可直接复核。
08对数据与评测行业的意义
质量必须在生产过程中被约束,交付后检查只能发现问题,无法消除问题。
- TASK DATA任务数据要带可校验的结构义务契约把「每个图必须出现一次、引用必须解析」写成机器可查的规则。长程任务数据同理,每个任务应附带必须满足的产物清单和引用关系,标注时就逐项勾验。
- VERIFIER验证器要分层,确定性检查放在最后一道Renderer 的校验是确定性的,评估 Agent 的判断是概率性的。前者保证底线,后者承担语义。把两者混成一个打分器,底线就守不住。
- EVALUATION评测要拆维度,并保留逐评审明细八个维度加十位评审的矩阵,让每一处提升都能定位到具体维度与具体人。单一总分掩盖分歧,E3 与 E8 的反差只有明细才看得见。
- LIMIT结构合规不等于科学正确论文自己承认契约管不到推理质量。验证器必须单独覆盖证据与推理,这部分仍需领域专家,也是高质量数据的价值所在。
对 DataManing 的判断很明确:生成式管线的瓶颈已经从模型能力转到约束与验证的工程化。谁能提供带结构义务的任务数据、分层的验证器和维度化的评测,谁就决定下一代长程 Agent 的可靠性上限。
09引用
@article{qian2026story2proposal,
  title   = {Story2Proposal: A Scaffold for Structured Scientific Paper Writing},
  author  = {Qian, Zhuoyang and Shi, Wei and Lin, Xu and Ling, Li and Luo, Meng and others},
  journal = {arXiv preprint arXiv:2603.27065},
  year    = {2026}
}